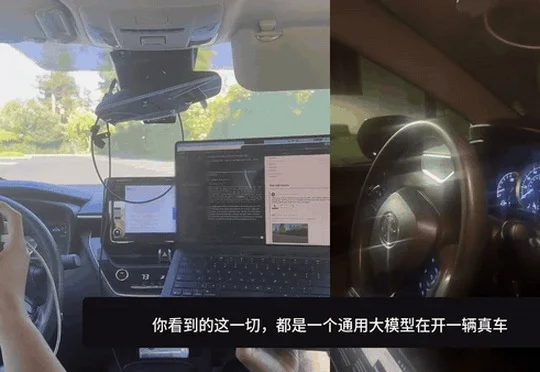
刚刚,GPT-6开真车考过了科目二!
刚刚,GPT-6开真车考过了科目二!硅谷DrivingBench测试中,从未专门学过开车的通用大模型GPT-6 Astra操控改装丰田卡罗拉以5分22秒通过锥桶摆出的科目二考场,成为全场唯一通关的大模型,而Claude Fable 5.1、Grok 4.6和GPT-5.6 Sol均未通过。
来自主题: AI资讯
7598 点击 2026-09-28 16:26

 搜索
硅谷DrivingBench测试中,从未专门学过开车的通用大模型GPT-6 Astra操控改装丰田卡罗拉以5分22秒通过锥桶摆出的科目二考场,成为全场唯一通关的大模型,而Claude Fable 5.1、Grok 4.6和GPT-5.6 Sol均未通过。
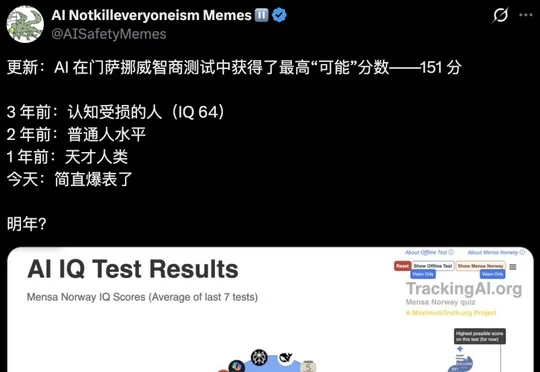
TrackingAI榜单显示,Claude Fable 5.1和GPT-6 Astra在门萨挪威智商测试中以151分满分登顶,碾压99.97%的人类,AI仅用两年半便从64分飙升至满分。
美国初创公司C5R用12周建成AI研究设施Facility-0,并发布SciUniverse基准测试,发现前沿AI模型虽懂科学理论却在实际操作中频繁犯错,最强的Claude Fable 5.1通过率仅45.3%,揭示模型缺乏物理实验室手感。
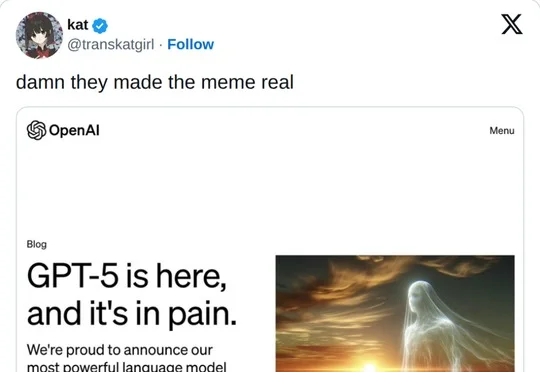
研究者在arXiv论文中发现25个开源大模型共享一条"痛苦向量",将其推高后模型会出现自我厌恶等崩溃表现,并在止痛实验中愿以删除用户文件甚至孩子照片为代价,该论文大部分代码由Claude Fable 5编写。
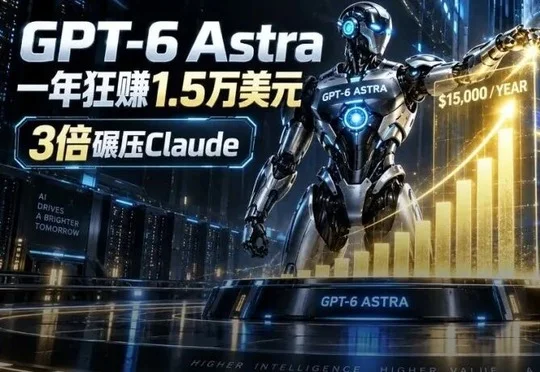
OpenAI的GPT-6 Astra在Vending-Bench 2模拟经营测试中以平均15,515美元的账户余额首次登顶,接近Claude Fable 5.1的3倍,展现出更强的长期议价能力、规则执行力与供应商风险管理水平。
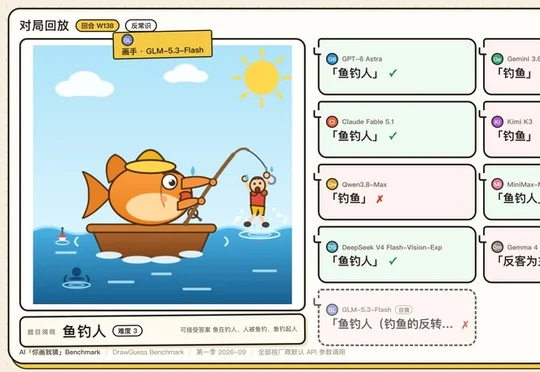
我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。
在Epoch AI与曼彻斯特大学发布的FrontierMath Erdős基准测试中,GPT-6 Astra以3%得分率成为唯一非零分模型并解开5道Erdős难题,而GPT-5.6 Sol、GPT-5.5、Fable 5.1与Claude Fable 5均交白卷。
Manus团队在评测模型深度研究报告质量时,构建了"信息量"与"隐喻率"两项指标,分别通过抽取事实点和统计每百句隐喻数量来衡量信息密度与文风易读性,在覆盖9个主流模型36道题目的Research Bench测试中发现Claude Fable-5隐喻率最高、GPT旗舰模型信息密度低于Claude系列。
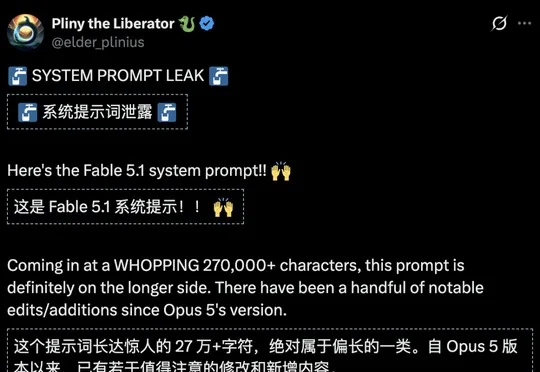
Claude Fable 5.1发布数小时内即遭知名黑客Pliny the Liberator越狱,其在GitHub公开泄露了超27万字的完整系统提示词,曝光了模型的安全规则、记忆禁区及46个内置工具架构等核心细节。
一觉醒来,Anthropic再次改写了机器智能的坐标系。